RAG Evaluation Skill
探索 GitHub 上的开源 Skill:查看真实 RAG 追踪记录,衡量失效层级,验证评估器,并评估生产就绪度。
AI 工程实验室 · 开放方法论
RAG Evaluation 找出哪一层出了问题,选择正确的衡量方式,验证评估器本身,并判断系统是否适合上线。
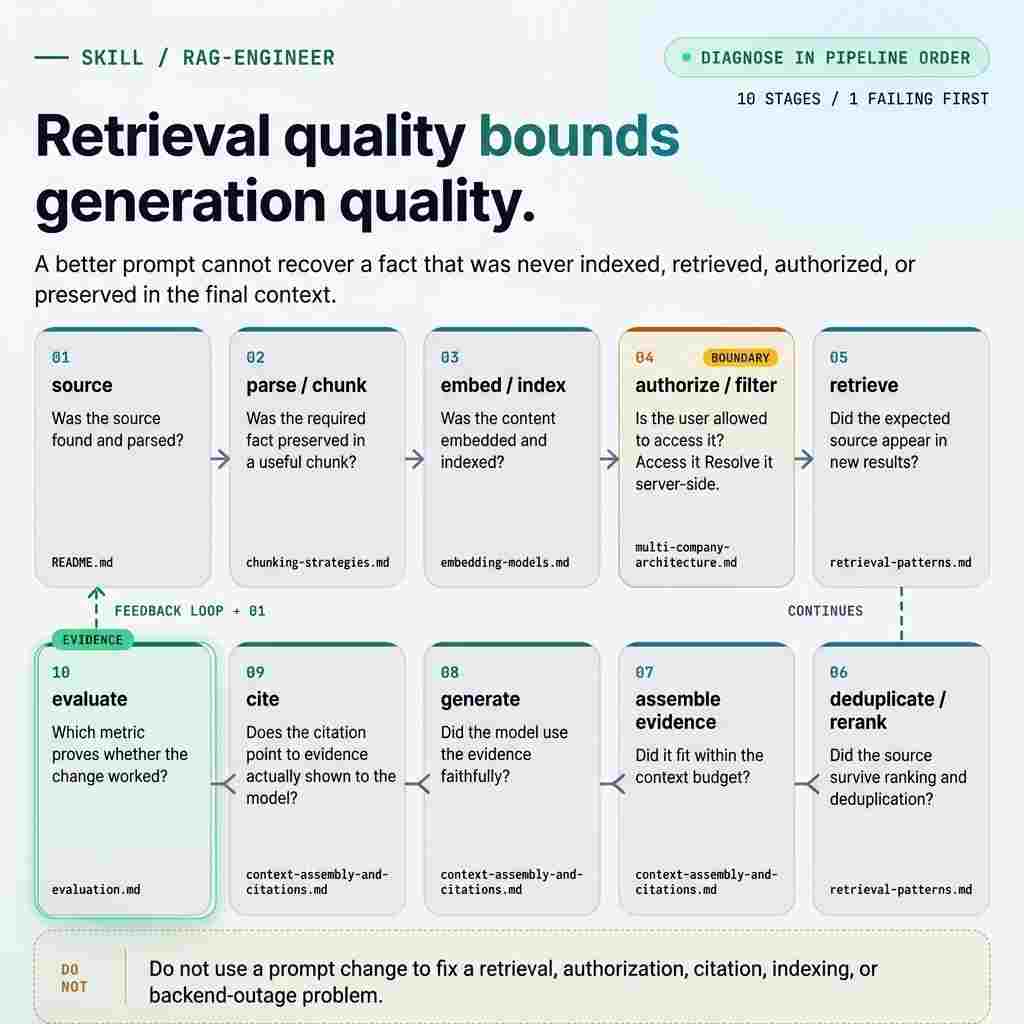
证据流水线
从用户实际遇到的失败开始,再将检索、生成、评估和生产就绪度作为独立问题持续观察。
探索 GitHub 上的开源 Skill:查看真实 RAG 追踪记录,衡量失效层级,验证评估器,并评估生产就绪度。
检索使用 Recall@k、Precision@k、MRR 或 NDCG;检索稳定后再评估忠实度和相关性。
尽可能使用代码,并用人工标注、TPR、TNR 和混淆矩阵验证二元 LLM 评估器。
上线前审查可靠性、可扩展性、安全、成本、数据管理和核心流水线质量。